모찌 새싹 개발기 1편: MuJoCo로 시작하는 첫 물리 시뮬레이션
힌지 하나짜리 진자, 중력 두 가지 설정, 그리고 앞으로 모든 로봇 결정을 가늠할 기준선
1. 왜 모찌 새싹을 시작했나
지난 8년, 나는 소프트웨어 쪽에서 ML 시스템을 만들어왔다 — Hulu, HBO Max, Nike, Meta, CloudBees — 주로 데이터 파이프라인, 평가, AI 에이전트였다. 내가 제일 잘하는 건 시스템을 숫자로 판단할 수 있게 만드는 일이다. 할 일을 정의하고, 궤적을 기록하고, 고정된 테스트셋으로 평가하는 것.
모찌 새싹은 그 일을 물리 세계로, 공개로, 오픈소스로 옮겨보려는 시도다. 장기 목표는 작고 오리지널한 이족보행 반려 로봇이다. 걷는 것부터 시작해 따라오고, 주인 취향을 배우고, 정해둔 기준을 넘겼을 때만 새 행동이 열린다. 그렇게 자라는 로봇이다. 캐릭터는 크림색 둥근 몸에 스크린 눈, 머리 위 작은 새싹. 있는 캐릭터를 베낀 게 아니라 처음부터 만든 오리지널이다.
이 프로젝트가 로봇팔 데모가 아닌 건 일부러다. 로봇팔 데모는 보기엔 완성된 것 같지만, 막상 물건을 잡으려면 까다로운 경우(예상치 못한 변수들)가 끝없이 나온다. 균형 잡고, 넘어지고, 일어나고, 주인에게 맞춰지는 작은 반려 로봇이야말로 Physical AI가 실제로 쓰는 능력 — 시뮬레이션, 동역학, 제어, 평가, Sim-to-Real — 을 제대로 시험한다.
2. Physical AI 커리어 목표
이 시리즈는 제품 출시가 목적이 아니다. 커리어를 바꾸기 위한 포트폴리오다. 목표는 순서대로 이렇다.
- Robotics Simulation / Evaluation / AI Infrastructure Engineer — 다른 엔지니어가 신뢰할 수 있는 시뮬레이터, 테스트 하네스, 평가를 만든다.
- Embodied AI / Robot Learning Engineer — 인식, 행동 선택, 학습된 정책을 연결한다.
- Physical AI Engineer — 시뮬레이션에서의 학습부터 실제 하드웨어 배포까지 로봇 하나를 책임진다.
이 순서가 중요한 건, 가진 걸 버리는 게 아니라 그 위에 얹기 때문이다. ML 파이프라인, 에이전트 평가, 백엔드 시스템 위에 로봇 동역학, 제어, 시뮬레이션, 센서, 하드웨어 경험을 얹는 것. 8년을 버리고 새로 시작하는 게 아니다.
모든 마일스톤은 같은 워크플로를 밟는다.
공부 → 실험 → 빌드 → 평가 → 기록 (Study → Experiment → Build → Evaluate → Document)
마일스톤 통과 조건은 다섯 가지다. 공부를 내 말로 정리할 것, 작은 실험에서 파라미터 하나를 바꿔 결과를 비교할 것, 코드를 커밋할 것, 숫자를 잴 것, 블로그 글을 남길 것. 코드로 이어지지 않은 공부는 한 셈 치지 않고, 글로 남지 않은 빌드는 만든 셈 치지 않는다.
3. 하드웨어보다 시뮬레이션이 먼저인 이유
25cm, 1kg 미만의 이족보행은 하드웨어로 풀기 어려운 문제다. 관절 토크, 무게중심, 발 접촉, 배터리 무게, 발 크기까지 다 얽혀 있다. 시뮬레이션이 그걸 해결해주진 않지만, 첫 실패를 싸게 만들어준다.
그래서 순서는 CartPole → 단순 이족보행 → 모찌 새싹 모델이다. 먼저 단순한 시스템에서 균형과 학습을 증명하고, 캐릭터 껍데기 없는 단순 이족보행으로 움직임을 증명하고, 같은 제어 구조를 새싹의 질량·관절·무게중심에 맞게 옮기면서 무엇이 바뀌고 성능이 어떻게 달라지는지 기록한다.
Day 1은 CartPole보다 한 단계 앞선 일이다. 툴체인 자체가 재현 가능한지를 증명하는 것. 같은 진자를 두 번 돌려 같은 숫자가 안 나오면, 그 뒤의 PPO, 보상 설계, 도메인 랜덤화는 아무것도 믿을 수 없다.
4. MuJoCo와 개발 환경
측정된 환경 (실험 기록 기준): Python 3.11.8, MuJoCo 3.17.0, macOS 26.6.2 ARM64. 저장소는 yunsupj/mochi-sprout, 커밋 b387c803a7ddf6192ace782515fff94377a7ff95, uv.lock으로 의존성 버전을 고정했다.
Day 1에 MuJoCo를 고른 건 작고 빠르고 접촉까지 되는 물리 엔진에 공식 Python 바인딩이 있고, Microduck 프로젝트도 MuJoCo + PPO 학습에 같은 엔진을 쓰기 때문이다. Isaac Lab은 나중 단계다. 한 가지 행동을 MuJoCo에서 검증한 뒤에 넓히는 거지, Day 1에 필요한 건 아니다.
프로젝트 구조는 저장소의 계획 그대로다.
mochi-sprout/
├── README.md
├── docs/
│   ├── phase0-day1.md
│   ├── learning-gates.md
│   └── day1-handoff.md
├── experiments/day01/
│   ├── README.md
│   └── results.json
├── src/mochi_sprout/simulation/pendulum.py
└── tests/test_pendulum.py
5. 일반화 좌표 이해하기
일반화 좌표(generalized coordinate)는 시스템의 배치를 설명하는 데 필요한 가장 작은 변수 집합이다. 이 진자는 힌지가 하나라 각도 하나면 된다. 각도를 알면 막대가 어디에 있는지 다 안다. 그게 전체 배치다.
MuJoCo는 세상을 두 가지 객체로 나눈다. 이 구분은 앞으로 모든 단계에서 중요하다.
MjModel은 기하학과 옵션을 담는다 — 시스템이 무엇인지.MjData는 변하는 상태를 담는다 — 시스템이 지금 무엇을 하고 있는지.
각도는 data.qpos[0]에 라디안 단위로, 그 변화율인 각속도는 data.qvel[0]에 rad/s 단위로 저장된다. 가속도는 속도의 변화율이다. MuJoCo는 매 스텝마다 힘, 구속조건, 지금 상태에서 가속도를 계산한다. data.ctrl에는 액추에이터 명령이 들어가는데, 이 모델엔 액추에이터가 없어서 data.ctrl 길이가 0이고 어떤 명령도 들어가지 않는다.
6. qpos, qvel, 그리고 시뮬레이션 상태
src/mochi_sprout/simulation/pendulum.py의 모델은 내려받은 에셋이 아니라 명시적인 MJCF다.
<mujoco model="day01_pendulum">
  <option timestep="0.002" gravity="0 0 -9.81" integrator="RK4"/>
  <worldbody>
    <body name="bob" pos="0 0 0">
      <joint name="hinge" type="hinge" axis="0 1 0" damping="0.01"/>
      <geom name="rod" type="capsule" fromto="0 0 0 0 0 -0.5"
            size="0.025" mass="1"/>
    </body>
  </worldbody>
</mujoco>
y축 힌지에 붙은 0.5m, 1kg 캡슐에 관절 댐핑 0.01이다. 러너는 초기 상태를 정한 뒤 0.002초 타임스텝으로 mj_step을 1,000번 호출해 2초까지 시뮬레이션하고, t = 0과 매 50스텝(0.1초마다) 상태를 기록한다.
def simulate(gravity_z: float = -9.81) -> list[dict[str, float]]:
    model = make_model(gravity_z)
    data = mujoco.MjData(model)
    data.qpos[0] = INITIAL_ANGLE_RAD   # 0.5 rad
    data.qvel[0] = INITIAL_VELOCITY_RAD_S  # 0 rad/s
    mujoco.mj_forward(model, data)
    steps = round(DURATION_S / model.opt.timestep)  # 1000
    trajectory = [_sample(data)]
    for step in range(1, steps + 1):
        mujoco.mj_step(model, data)
        if step % SAMPLE_EVERY_STEPS == 0 or step == steps:
            trajectory.append(_sample(data))
    return trajectory
해석: qpos와 qvel이 곧 상태다. 기록된 샘플에 이 둘만 있으면 이 시뮬레이션을 정확히 같은 상태에서 다시 시작할 수 있다. 그래서 실험 기록은 매 샘플마다 둘 다 저장한다.
7. 중력, 토크, 진자 동역학
중력은 막대의 질량을 당긴다. 막대가 기울어져 있으면 그 당김이 힌지 주위로 회전 효과 — 토크 — 를 만든다. 같은 각도에서 중력이 강할수록 복원 토크가 강해져서 막대가 더 빠르게, 다른 위상으로 흔들린다. 관절 댐핑이 움직임에 저항하기 때문에, 기록에서 흔들림이 끝없이 커지지 않는다.
단순 진자에 대해 이 생각을 교과서 형태로 쓰면 이렇다.
여기서 는 각도, 는 관성, 는 댐핑, 은 질량, 는 중력, 은 질량중심까지의 거리다. 해석이지, 측정한 피팅이 아니다. 이 모델은 점질량이 아니라 캡슐이라 정확한 와 질량중심은 교과서의 점질량 경우와 다르다. 이 식이 MuJoCo 숫자를 계수까지 재현한다고 주장하는 게 아니다. MuJoCo는 매 스텝 힘과 구속조건에서 가속도를 계산한다. 이 식을 여기에 둔 건 학습 게이트가 요구한 멘탈 모델이기 때문이다. 중력 → 토크 → 각가속도 → 새 qvel → 새 qpos.
프로젝트 전체에서 중요한 제어 용어 두 가지를, 제어기가 아직 없는데 여기서 먼저 배웠다.
- 개루프(Open-loop) 제어는 관측된 상태를 이용해 바로잡지 않고 명령을 정한다.
- 폐루프(Closed-loop) 제어는 상태나 센서를 읽고 다음 명령을 조정한다.
Day 1에는 제어기도 액추에이터도 없다. 움직임은 중력과 댐핑에 대한 자유 응답이다. 앞으로 어떤 제어기가 오든 비교 기준선은 이거다.
8. 실험 설정
측정된 설정 (experiments/day01/README.md와 results.json 기준):
| 설정 | 값 |
|---|---|
| 실험 ID | day01-pendulum-gravity |
| 기록 시각 | 2026-11-04 19:16:10 −08:00, America/Los_Angeles |
| 모델 | y축 힌지 1개; 0.5m, 1kg 캡슐; 댐핑 0.01; RK4 |
| 초기 상태, 두 실행 모두 | qpos = 0.5 rad, qvel = 0 rad/s |
| 타임스텝 | 0.002초; 지속 2초 (1,000스텝) |
| 샘플링 | t = 0, 이후 매 50스텝 (0.1초); 실행당 21개 샘플 |
| 실행 A 중력 | (0, 0, −9.81) m/s² |
| 실행 B 중력 | (0, 0, −3.0) m/s² |
| 제어 | 액추에이터 없음, 적용된 ctrl 없음 |
| 테스트 | pytest 5개 검사, §10 참조 |
실행 전 기대: 중력을 바꾸면 궤적이 바뀔 것이다. 실행 전엔 검증되지 않은 것: 얼마나, 그리고 어느 시점에 차이가 가장 클지. 아래 숫자는 미리 쓴 예측이 아니라 측정값이다.
9. 실제 측정된 실험 결과
측정값 — 마지막 샘플, t ≈ 2.0초:
| 중력 z (m/s²) | qpos (rad) | qvel (rad/s) |
|---|---|---|
| −9.81 (A) | −0.21383601484656056 | 2.069170516798967 |
| −3.0 (B) | 0.3920126521060395 | 0.587366201059721 |
측정값 — 기록된 샘플 중 최대 각도 차이: 0.9085448978228956 rad, t = 1.2초에서 (A: 0.466074 rad, B: −0.442471 rad). 두 궤적 모두 qpos = 0.5 rad, qvel = 0 rad/s에서 똑같이 시작했다.
results.json에서 가져온 일부 샘플 (소수점 6자리로 반올림, 전체 21개 샘플 궤적은 저장소에 있다):
| t (초) | A qpos | A qvel | B qpos | B qvel | |Δq| |
|---|---|---|---|---|---|
| 0.0 | 0.500000 | 0.000000 | 0.500000 | 0.000000 | 0.000000 |
| 0.5 | −0.419636 | −1.254904 | 0.068491 | −1.406207 | 0.488126 |
| 1.0 | 0.237389 | 2.131831 | −0.455974 | −0.322051 | 0.693363 |
| 1.2 | 0.466074 | −0.041050 | −0.442471 | 0.450545 | 0.908545 |
| 1.5 | −0.005433 | −2.418169 | −0.169465 | 1.250993 | 0.164032 |
| 2.0 | −0.213836 | 2.069171 | 0.392013 | 0.587366 | 0.605849 |
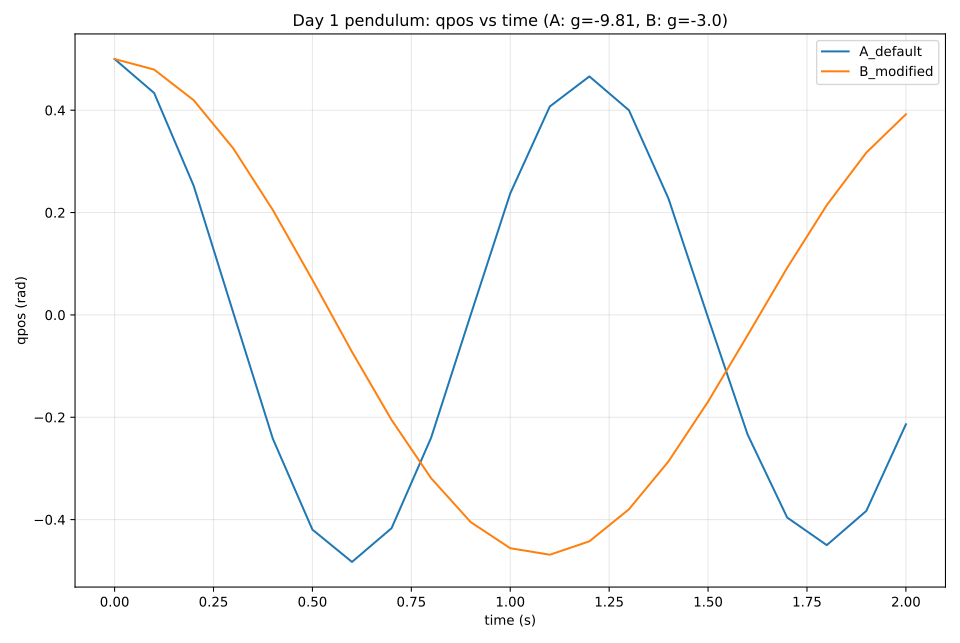
그림: 검증된 results.json 궤적에서 그린 시간에 따른 qpos. 실행 A(지구 중력)가 실행 B(감소된 중력)보다 더 빠르게, 더 위상이 어긋나게 흔들린다. 이것은 데이터 그래프이지 실제 로봇 사진이 아니다. 실제 로봇은 아직 존재하지 않는다.
나는 체크인된 results.json 궤적에서 마지막 값과 최대 차이를 직접 다시 계산했고, 파일 안 observations 블록과 정확히 일치하는 걸 확인했다. JSON 파일은 2026-11-04에 기록됐고 커밋 b387c80에 들어 있다.
10. 기술적 해석
일부러 단순하게 만든 실험에서 가져갈 건 세 가지다.
- 같은 상태, 다른 물리, 다른 결과. 두 실행은 중력이라는 입력 하나만 다르고, t = 1.2초가 되면 각도가 0.91 rad 벌어져 거의 수직선의 반대편에 있다. 통제된 실험의 핵심이 바로 이거다. 변수 하나, 나머지는 전부 고정.
- 끝점보다 위상이 중요하다. t = 2.0초 차이는 0.61 rad이지만, t = 1.2초 차이는 0.91 rad이다. 마지막 각도만 보고 판단하면 두 흔들림이 얼마나 다른지 과소평가하게 된다. 나중에 보행 정책을 평가할 때도 같은 교훈이 적용된다. 최종 상태만이 아니라 궤적을 봐야 한다.
- 결정성은 현실의 속성이 아니라 설정의 속성이다. pytest 5개 검사 — 모델 로딩(
nq == 1,nv == 1), 2초까지 시간 진행, 상태 유한성, 반복 실행 1e−12 절대 오차 내 일치, 중력 변경 시 궤적 차이 0.01 rad 초과 — 를 통과했다. 원래 실행은 3.68초에 5개 통과, 나중 최종 확인 실행은 같은 머신에서 0.18초에 5개 통과했다. 시간 차이는 머신 타이밍이지 다른 결과가 아니다. 한 머신에서의 반복 가능성은 기준선이다. 물리적 정확성의 증명도 아니고, 플랫폼 간 비트 단위 동일성의 증명도 아니다.
11. 실패, 한계, 배운 점
- 설정 실패 후 재시도. 첫 의존성 설치는 개발 샌드박스에서 PyPI에 닿지 못했다(DNS 실패). 승인된 네트워크 접근으로 다시 시도해 성공했고,
uv기본 캐시도 접근이 안 돼서 임시 캐시를 썼다. 실험 README에 기록돼 있고 숨기지 않았다. 환경 실패도 재현성의 일부다. - 이상화된 모델. 강체 캡슐 하나, 이상적인 힌지 하나, 모터 없음, 센서 없음, 접촉 없음, 제작 공차 없음, 측정된 하드웨어 파라미터 없음. 실제 진자와 비교한 적이 없다.
- 타임스텝 수렴 검사는 안 했다. 더 작은 타임스텝은 수치 오차와 계산 비용을 바꿀 수 있다. 그 자체가 물리적 정확성의 증명은 아니다. 그 검사는 나중 실험에 속한다.
- 샘플링이 피크를 놓칠 수 있다. 물리는 0.002초마다 진행되는데 기록은 0.1초마다 하므로, 보고된 최대 차이(0.9085 rad)는 기록된 샘플 중 최대값이다. 샘플 사이에 더 큰 차이가 있었을 가능성은 검증되지 않았다.
- 플랫폼 간 차이는 예상된다. README에도 다른 하드웨어와 MuJoCo 빌드에서는 작은 수치 차이가 날 수 있다고 적혀 있다. 재현해서 t = 2초에 −0.213836이 아니라 −0.214가 나왔다면 예상 범위 안이다. 질적으로 다른 흔들림이 나왔다면 설정이 어딘가 다르다는 뜻이다.
- 프로젝트에 대한 교훈: 블로그 글보다 실험 기록을 먼저 쓰고, 블로그 글이 그 기록을 인용하게 하라. 그 순서가 이 시리즈가 커져도 정직하게 유지되는 방법이다.
12. 재현 방법
저장소 루트에서 Python 3.11과 uv가 설치된 상태로 실행한다.
uv sync --locked --python 3.11
uv run --locked --python 3.11 pytest -q
uv run --locked --python 3.11 python -m mochi_sprout.simulation.pendulum --output experiments/day01/results.json
마지막 명령은 새 기록 시각으로 results.json을 다시 생성한다. 궤적 값을 체크인된 기록과 비교하면 된다. 플랫폼에 따라 작은 부동소수점 차이가 날 수 있다. uv.lock에 의존성 버전이 기록돼 있다. 이 글의 검토에서 검증되지 않은 것: 나는 코드를 검사하고 체크인된 JSON에서 관측값을 다시 계산했지만, 이 검토 환경에서는 MuJoCo를 직접 다시 실행하지 않았다(환경은 Python 3.12에 uv가 없고, 프로젝트는 Python 3.11을 요구한다). 위 세 명령을 Python 3.11 머신에서 다시 실행하는 게 남아 있는 독립 재현 단계이며, 독자와 다음 검토에 맡긴다.
관련 파일 (커밋 b387c80):
- README.md
- src/mochi_sprout/simulation/pendulum.py
- experiments/day01/README.md
- experiments/day01/results.json
- tests/test_pendulum.py
- docs/phase0-day1.md
- docs/learning-gates.md
13. 모듈형 오픈소스 아키텍처
Day 1은 일부러 작다. 하지만 구조는 프로젝트 전체가 커져갈 구조 그대로다. 시뮬레이션 모듈(src/mochi_sprout/simulation/)은 모델과 러너를 담고, experiments/는 날짜별 실험 폴더마다 README와 JSON을, docs/는 학습 게이트와 방법 노트를, tests/는 모델이 바뀌어도 계속 통과해야 하는 검사를 담는다.
진자 실험을 재현하고, 소스를 살펴보고, 중력이나 초기 각도를 설정에서 바꿔보고, 자동 테스트를 돌리고, 개선을 기여할 수 있다. CONTRIBUTING.md를 참조하면 된다. 작고 근거 있는 변경을 환영한다. 아직 할 수 없는 것 — 존재하지 않기 때문이다 — 은 보행 정책, Embodied Agent, 하드웨어를 돌리는 것이다. 로드맵의 제안이지 현재 기능이 아니므로, 있는 것처럼 광고하지 말라.
저장소는 Apache-2.0이다. 캐릭터 아트워크, 로고, 브랜딩은 별도 라이선스가 필요할 수 있다. 이 릴리스에는 그런 에셋이 포함돼 있지 않다.
14. 다음 학습 마일스톤
Day 1 학습 게이트는 통과로 기록됐고, Day 1 마무리 과정에서 프로젝트 오너가 확인했다. 다섯 가지 자가 점검 질문은 새 기여자를 위해 docs/learning-gates.md에 남아 있다. 일반화 좌표가 하나면 충분한 이유와 MuJoCo에서 어디에 저장되는지, qvel[0]의 의미와 가속도와의 관계, 같은 시작점에서 중력을 바꾸면 왜 나중 qpos가 달라지는지, 0.002초 타임스텝으로 2초를 만들려면 mj_step을 몇 번 호출해야 하고 타임스텝을 바꾸면 무엇이 달라지는지, 모터를 달면 ctrl에 무엇이 들어가고 개루프 명령이 폐루프와 어떻게 다른지.
다음 학습 주제는 PID와 피드백 제어다. 다음 구현 단계는 CartPole이다. 같은 단순한 시스템에 PID를 적용하고, 학습된 제어기와 비교해서 그 차이를 형용사가 아니라 로그로 기록한다.
그것이 다음 글이다. 로봇이 아니다. 제어기, 측정된 것.
업데이트 (2026년 11월): 그 제어기 글이 발행됐다 — 모찌 새싹 개발기 2편: P·PI·PD·PID 제어기 비교 실험.
업데이트 11/6/2026